Нейросеть для анализа документов: что находит и ошибки
Нейросеть находит пункт в договоре, достаёт реквизиты и сроки, отвечает по регламенту. Где ошибается, как проверить ответ и как собрать агента по документам.
Нейросеть находит в документе нужный пункт, достаёт реквизиты и сроки, сверяет версии. Ошибается на длинных текстах, плохих сканах и сложных таблицах, поэтому ответ просят с цитатой и проверяют по источнику. Агент Савви отвечает по базе документов компании и читает файл, который прислал клиент.
Договор на сорок страниц, а нужное условие спрятано в пункте 7.3.2 и ссылается на приложение 3. Читать целиком ради одной строки долго, пролистать рискованно.
Нейросеть для анализа документов — это языковая модель, которая читает текст договора или регламента и возвращает факты с указанием места, где они найдены. Пользу она приносит, если знать, что ей поручать и как перепроверять.
Какие задачи с документами нейросеть решает хорошо
Нейросеть берёт на себя пять задач — находит пункт по вопросу, выписывает реквизиты и сроки, сверяет две версии текста, проверяет документ на полноту и отвечает по регламенту. Все пять сводятся к одному — прочитать текст и достать из него факт с указанием места.
Отдельно стоят нормативные документы компании — положения, инструкции, регламенты. По ним люди чаще всего спрашивают «а что у нас написано про…», и это самый безопасный сценарий. Ответ сверяется за секунды, а ошибка не превращается в юридическое решение. Сюда же относится подготовка документов: нейросеть собирает черновик из ваших вводных, но проверку каждого факта и цифры в нём никто не отменял.
Выберите задачу, и схема покажет, что с ней делать и чем проверять результат.
Нейросеть читает документ и показывает места, где говорится о нужном условии.
- Что просить
- Дословную цитату и номер пункта
- Риск
- Условие в середине длинного текста
- Как проверить
- Открыть названный пункт в файле
Нейросеть сопоставляет две редакции и выводит изменения списком или таблицей.
- Что просить
- Таблицу: пункт, было, стало
- Риск
- Отличия из середины длинных версий легко пропустить
- Как проверить
- Сверить спорные строки в обеих версиях
Нейросеть собирает стороны, суммы, даты и штрафы в короткий список.
- Что просить
- Список с номером пункта у каждой позиции
- Риск
- Цифры из скана низкого качества
- Как проверить
- Сверить суммы и даты с оригиналом
Нейросеть сверяет текст с вашим перечнем обязательных разделов.
- Что просить
- Отметить каждый раздел из перечня: есть или нет
- Риск
- Длинный контекст снижает полноту ответа
- Как проверить
- Открыть разделы с отметкой «нет»
Сотрудник или клиент спрашивает обычными словами, нейросеть отвечает по тексту.
- Что просить
- Ответ только по документу и ссылку на раздел
- Риск
- Ответ без опоры на текст, если не просить цитату
- Как проверить
- Сверить цитату с разделом регламента
Где нейросеть ошибается при анализе документов
Нейросеть ошибается там, где текст трудно прочитать или удержать целиком — в середине очень длинных файлов, на плохих сканах и в плотных таблицах. У каждой из этих ошибок есть понятная причина.
Длинный текст. По документации Anthropic, чем больше токенов в контексте, тем ниже точность и полнота ответа, это явление там называют context rot. Исследование «Lost in the Middle» (Liu и соавторы, Стэнфорд, 2023) показало: модели лучше используют начало и конец длинного текста и хуже середину. Если условие из пункта 7.3.2 окажется в середине файла, шанс его пропустить выше. Окно до 1 млн токенов у текущих моделей этого не отменяет: по той же документации, больше контекста не всегда лучше.
Сканы и PDF. По документации Anthropic, каждая страница PDF превращается в изображение, а текст страницы подаётся рядом с картинкой. Плотные файлы с мелким шрифтом и сложными таблицами могут заполнить окно контекста раньше лимита страниц, поэтому большие документы советуют делить на части. Про качество картинки там же сказано, что при низком разрешении, повороте и очень мелких изображениях модель может ошибаться и додумывать.
Отсылки к другим файлам. Если пункт отсылает к приложению, загрузите приложение вместе с договором. Тогда ответ «в загруженном тексте этого нет» будет честным, а не следствием того, что нужная страница осталась за кадром.
Даже у самых сильных моделей бывает текст, который не соответствует исходному документу. Приёмы снижения таких ошибок руководство Anthropic описывает отдельно, но сразу оговаривает: полностью они ошибки не убирают, важное проверяют всегда. Microsoft в справке по Copilot в Excel даёт ту же рекомендацию для финансовой, юридической и медицинской сфер.
Как проверять ответ нейросети по документу
Надёжная проверка держится на одном правиле: у каждого утверждения есть дословная цитата и номер пункта, а утверждение без цитаты считается непроверенным. Эти приёмы Anthropic перечисляет в руководстве по снижению галлюцинаций: сначала выписать цитаты, затем отвечать по ним, разрешить ответ «не знаю» и ограничить ответ предоставленным текстом.
Готовый шаблон запроса. Подставьте вопрос и текст — остальное оставьте как есть:
Ты проверяешь документ по тексту ниже. Отвечай только по этому тексту.
Шаг 1. Выпиши дословные цитаты, которые относятся к вопросу, и укажи номер пункта у каждой.
Шаг 2. Ответь на вопрос, опираясь только на эти цитаты.
Шаг 3. Если в тексте ответа нет, напиши «в документе не найдено» и не додумывай.
Вопрос: [что нужно найти]
Текст: [вставьте документ или нужную часть]
Длинный документ режьте на части по разделам и задавайте вопрос к каждой части отдельно. Так нужный пункт не теряется в середине общего массива текста. Сам запрос пишется один раз и годится для любого договора, регламента или положения, меняется только вопрос. Дальше сверка занимает несколько минут.
| Что вернула нейросеть | Что сделать |
|---|---|
| Цитата с номером пункта | Открыть пункт в файле и сверить слово в слово |
| Сумма, дата, срок | Сверить с оригиналом, особенно если источник скан |
| Ответ «в документе не найдено» | Проверить, загружен ли нужный раздел и приложение |
| Вывод без цитаты | Считать непроверенным и запросить цитату |
Юридических заключений от такой проверки ждать не стоит — нейросеть показывает, что написано в тексте, а что это значит для вашего дела, решает юрист. Выдержки с номерами пунктов юристу удобны как заготовка перед работой с договором.
Как агент отвечает по документам компании
Агент отвечает по документам, если загрузить их в раздел «Документы» базы знаний: система режет файл на смысловые куски, находит те, что ближе всего к вопросу, и модель формулирует ответ на их основе. Принимаются PDF, DOCX и TXT до 10 МБ, плюс подключение Google Doc и GitBook. Для нормативных документов это удобный режим: регламент загружен один раз, и на вопросы сотрудников и клиентов агент отвечает по нему.
Вот как выглядит этот раздел в кабинете — сверху вкладки базы знаний, ниже блок загрузки документа.
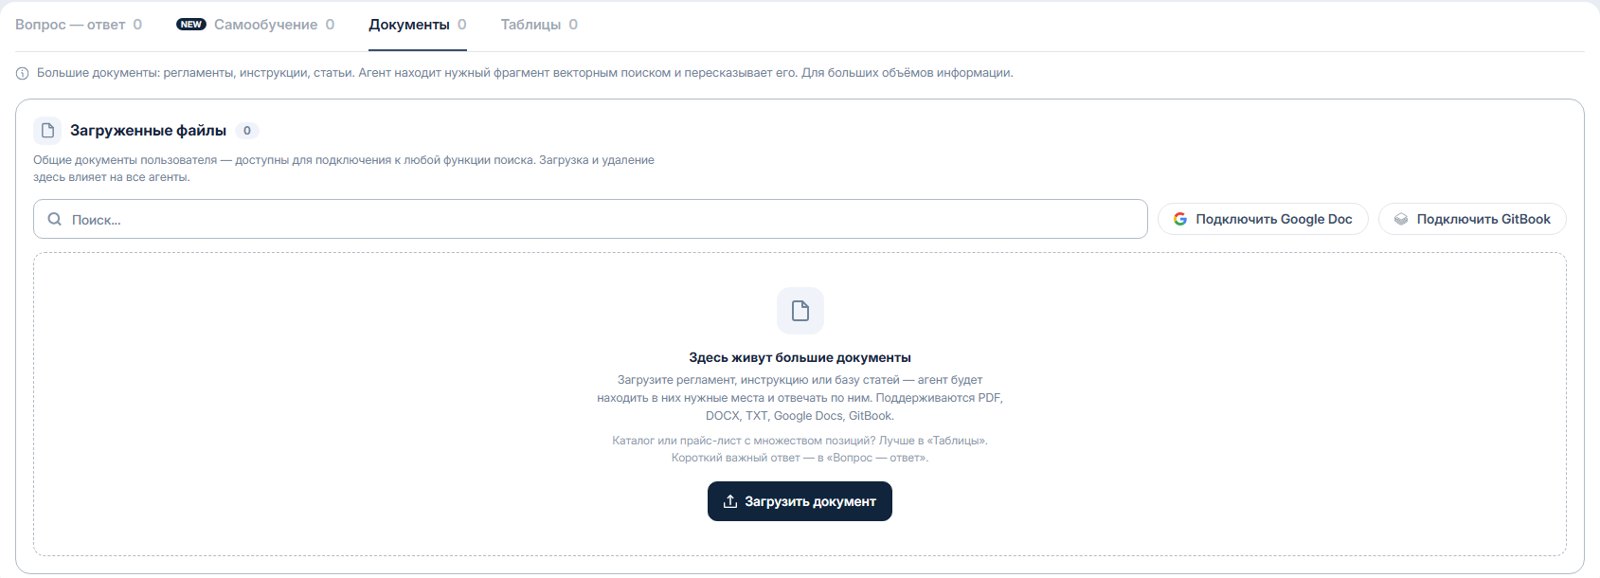
Точность поиска зависит от разметки: кусок не длиннее 2048 знаков, лучшая разбивка идёт по абзацам, а результат видно кнопкой «Показать чанки» до того, как документ начнёт отвечать людям. Размеченный по абзацам регламент отвечает точнее, а порог поиска и подготовка файла настраиваются отдельно.
Чтобы ответ можно было сверить с текстом, добавьте в инструкцию правило цитирования. Инструкция приоритетнее базы знаний, поэтому правило сработает:
Отвечай по документам компании. Если название раздела есть в тексте найденного куска, называй документ и раздел.
Если в найденных кусках ответа нет, скажи, что не нашёл, и предложи связать клиента с сотрудником.
Диалог с таким агентом стоит около 15 ₽ — распознавание сканов оплачивается отдельно.
Как агент читает документ, который прислал клиент
Файл клиента агент читает действием «Извлечь текст из файла»: оно принимает docx, pdf, rtf и txt и при включённом поле «Поместить полученный текст в переменную» передаёт текст в другие шаги. Клиент присылает договор или справку — агент находит нужное место и отвечает по содержимому именно этого файла.
Для сканов у действия есть «Режим чтения сканированного текста» с тремя вариантами: не использовать распознавание, использовать его для PDF хотя бы с одной картинкой или распознавать текст на изображениях всегда. Распознавание стоит 0,5 ₽ за страницу.
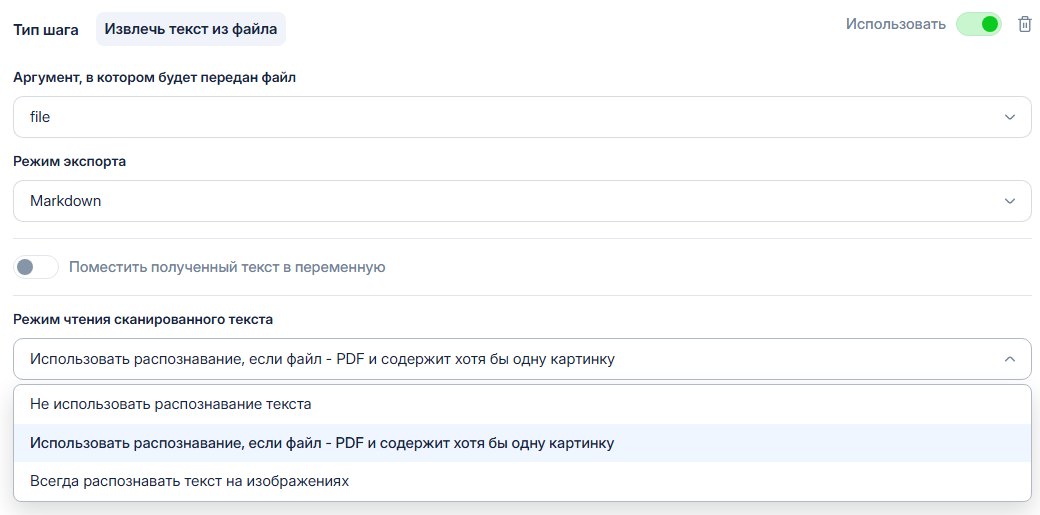
Здесь работают те же правила проверки, что и в чате с нейросетью. Скан под углом или с мелким шрифтом даёт неточный текст, поэтому суммы и даты из такого файла сверяют с оригиналом. Файл клиента читается в его диалоге, а постоянные ответы по регламенту обеспечивает загрузка в «Документы». Режим чтения стоит выставить под ваш поток сканов, а передачу фото в модель настраивают вместе с чтением файлов клиента. Когда документ нужно подготовить, а не прочитать, пригодится нейросеть для создания документов.
Когда схема понятна, можно загрузить регламенты в базу знаний агента и начать с двух-трёх документов: регламента и типового договора.
Проверьте нейросеть на документе, ответы по которому вы знаете
Проверьте нейросеть на документе, в котором вы сами знаете, где что лежит: возьмите регламент или типовой договор и выпишите пять вопросов с известными ответами и номерами пунктов. Два вопроса пусть касаются середины документа, один отсылки к приложению, один цифры из таблицы, один условия, которого в тексте нет.
Прогоните эти вопросы по шаблону с цитатами, затем так же через агента с загруженным документом. Отметьте три случая — где ответ совпал с вашим, где цитата указывала не туда и где нейросеть честно написала «не найдено». На пятом вопросе, ответа на который в документе нет, видно главное — выдумывает ли она. Результат покажет, каким документам можно доверять поиск пунктов уже сейчас, а какие стоит сначала разметить на абзацы или поделить на части.
Частые вопросы
Может ли нейросеть проверить договор на ошибки
Она может выписать стороны, сроки, суммы и штрафы, найти пункт по вопросу и показать места, где условие названо в одном разделе и расходится с другим. Правовую оценку она не заменяет: выводы по договору делает юрист, а нейросеть готовит выдержки с номерами пунктов.
Почему нейросеть пропускает пункт, который точно есть в документе
Чаще всего пункт лежит в середине длинного текста. По исследованию Стэнфорда «Lost in the Middle» (2023), модели лучше используют начало и конец длинного контекста и хуже середину. Помогает вопрос по частям документа и просьба сначала привести дословные цитаты.
Можно ли загружать в нейросеть сканы и фотографии документов
Можно, но точность зависит от качества картинки. По документации Anthropic, модель может ошибаться при низком качестве, повороте и очень мелких изображениях. Скан лучше снимать ровно и в хорошем разрешении, а извлечённый текст проверять по оригиналу.
Как проверить, что нейросеть не выдумала ответ
Просите дословную цитату и номер пункта у каждого утверждения, затем сверяйте цитату с файлом. Утверждение без цитаты считайте непроверенным. Приём из руководства Anthropic по снижению галлюцинаций: он уменьшает число ошибок, но полностью их не убирает.
Как агент в Савви отвечает по документам компании
Регламенты, положения и инструкции загружаются в раздел «Документы» базы знаний. Система режет файл на смысловые куски, находит ближайшие к вопросу клиента и передаёт их модели, которая формулирует ответ. Размер файла до 10 МБ, форматы PDF, DOCX и TXT.
Может ли агент прочитать документ, который прислал клиент
Да, для этого создаётся действие «Извлечь текст из файла». Оно принимает docx, pdf, rtf и txt, а для сканов есть режим чтения сканированного текста: 0,5 ₽ за страницу. Распознанный текст агент использует в ответе этому клиенту в текущем диалоге.
Хотите сразу к продукту: Разработка чат-ботов для бизнеса
Читайте дальше
Все статьи темы →
ИИ-агент и документы: ответы из ваших файлов
Как ИИ-агент отвечает по регламенту, прайсу в PDF или договору: разбивка на куски, поиск по смыслу, форматы файлов и переделка плохого документа в хороший.
ИИ-агент и PDF: что бот делает с файлом в переписке
Как ИИ-агент читает PDF от клиента, отправляет готовый файл и берёт документ в базу знаний: три разных сценария, лимиты и цена распознавания скана.
ИИ и юридические документы: что можно поручить
Какие задачи с документами ИИ-агент берёт на себя в юридической практике: ответы по регламенту, сбор данных для заготовки, приём файлов, напоминания о сроках.